文献周报 2026-W44
同一个支架,学习者带进来的不同,吸收的也不同:同样的 GenAI 元认知提示,前概念相异的小组把它织进讨论,相似的小组只当产出通道;50.9 万名大学生里,六成停在“替我做”式使用。
本期新入库 42 篇(英文期刊 17 篇,中文期刊 25 篇),另有 1 条国务院办公厅重点政策。主线是:同一个支架,学习者带进来的不同,吸收的也不同;测量正在从结果走向过程与生理。
- 一项协作探究研究中,同一个 GenAI 元认知提示,前概念相异的小组把 AI 交互织进概念讨论,前概念相似的小组只拿它当产出通道,并持续给出负面评价。
- 一项医学 PBL 研究在常规课中加一场不计分的同伴口试:心率变异性在常规 PBL 已有的激活之上再降,焦虑与压力上升、无聊下降,学生反而更喜欢。
- 一项游戏化测评研究用五个闯关场景测一到三年级的计算思维,510 人五因子结构成立;日志显示 94% 的学生能走到迷宫终点,只有 29% 找到最短路。
- 一项计算元综合让 LLM 执行三级编码、人逐级审核,从 71 篇文献中整合出高校 AI 素养五维框架。
- 一项覆盖 143 所高校、50.9 万名学生的调查显示,63.2% 的学生停留在浅层替代式使用生成式 AI,它与高阶思维负相关;只有 13.3% 进入深层交互式使用,与高阶思维正相关。
本期头条
同样的 AI 提示,两种小组两种用法
GenAI-based metacognitive prompting in collaborative inquiry: A comparison across diverse preconception groups(British Journal of Educational Technology,10.1111/bjet.70095)
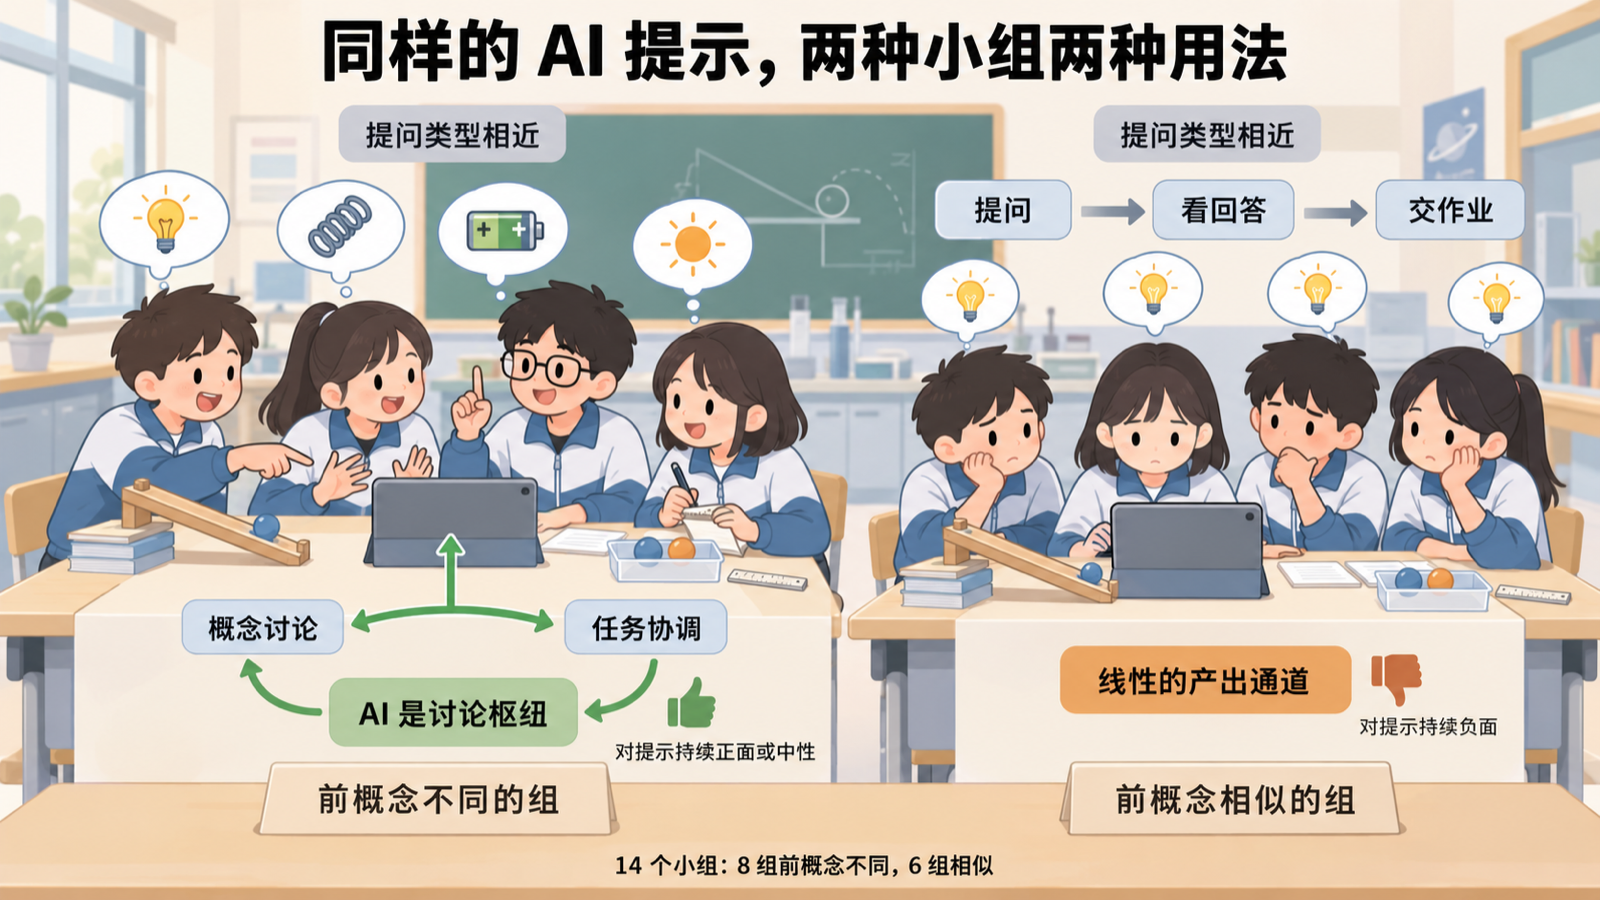
- 设计:14 个协作探究小组按成员关于能量形式与守恒的前概念分为相异组(8)与相似组(6),小组向书面元认知 AI 提问并获得 GenAI 生成的元认知提示;交互编码后依次做提问分布比较、滞后序列分析、过程挖掘。
- 发现:两类组发给 AI 的问询类型大体相同;相异组对提示持续正面或中性评价,相似组持续负面;相异组中“AI 询问协商”是连接概念讨论与任务协调的枢纽,相似组只是“提问→处理回答”的线性链。
- 可借鉴的设计:先排除“输入不同”,再把差异落到过程结构上;分组变量是小组知识构型而不是个体先验水平。研究未测学习结果。
PBL 里加一场同伴口试:更紧张,也不无聊了
Peer-led examination simulation reshapes psychophysiological and emotional state profiles during problem-based medical learning(npj Science of Learning,10.1038/s41539-026-00459-x)
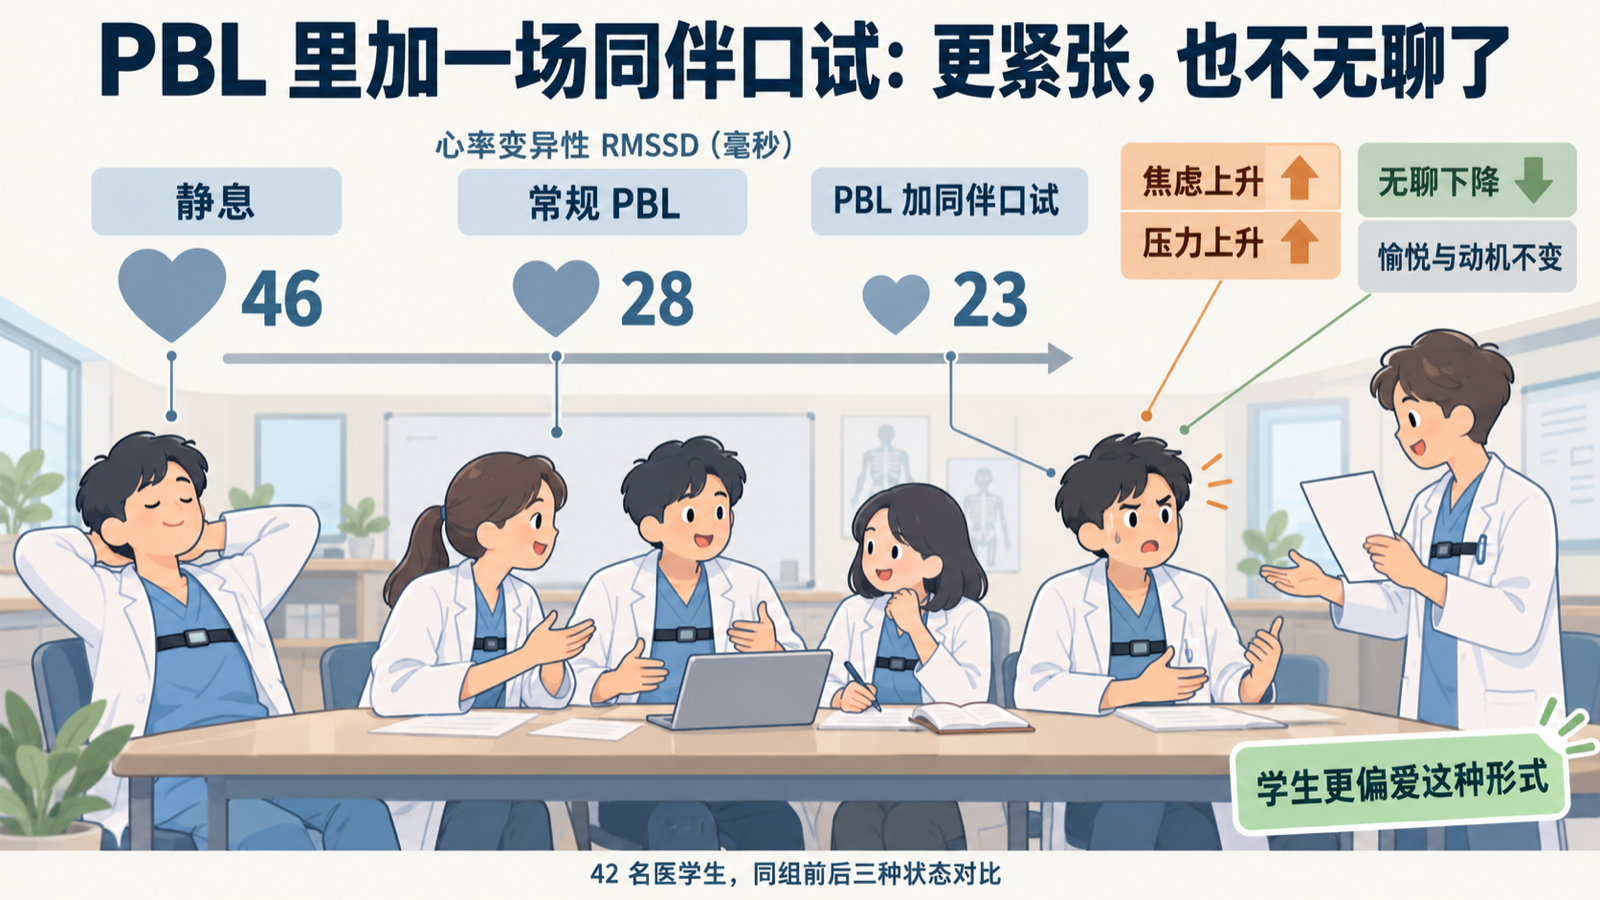
- 设计:42 名医学生,被试内三种状态:静息、常规 PBL、把 PBL 汇报环节换成不计分的同伴口试(学生自拟考题、轮换考生与考官)。胸带测心率变异性,学业情绪量表与视觉模拟量表测情绪;按每人开始发言的时刻切 0–5、5–10 分钟窗口;控制静息心率变异性的混合模型与族内错误发现率校正。
- 发现:RMSSD 从静息 46.24 ms 降到常规 PBL 27.79 ms,口试时 22.59 ms(口试对常规 dz = −0.60);焦虑、知觉压力上升,无聊下降(dz = −0.57),愉悦、动机、自评表现不变;学生更偏好口试形式(dz = 0.74);课后压力回落到与常规相同。
- 阅读提示:条件顺序固定、两次课病例不同,只能作关联解读;没有客观学习结果;只测心率变异性,而说话本身会改变它。
一到三年级的计算思维,在闯关游戏里测
Development and validation of a game-based assessment tool for computational thinking practices in lower primary students(Computers & Education,10.1016/j.compedu.2026.105752)
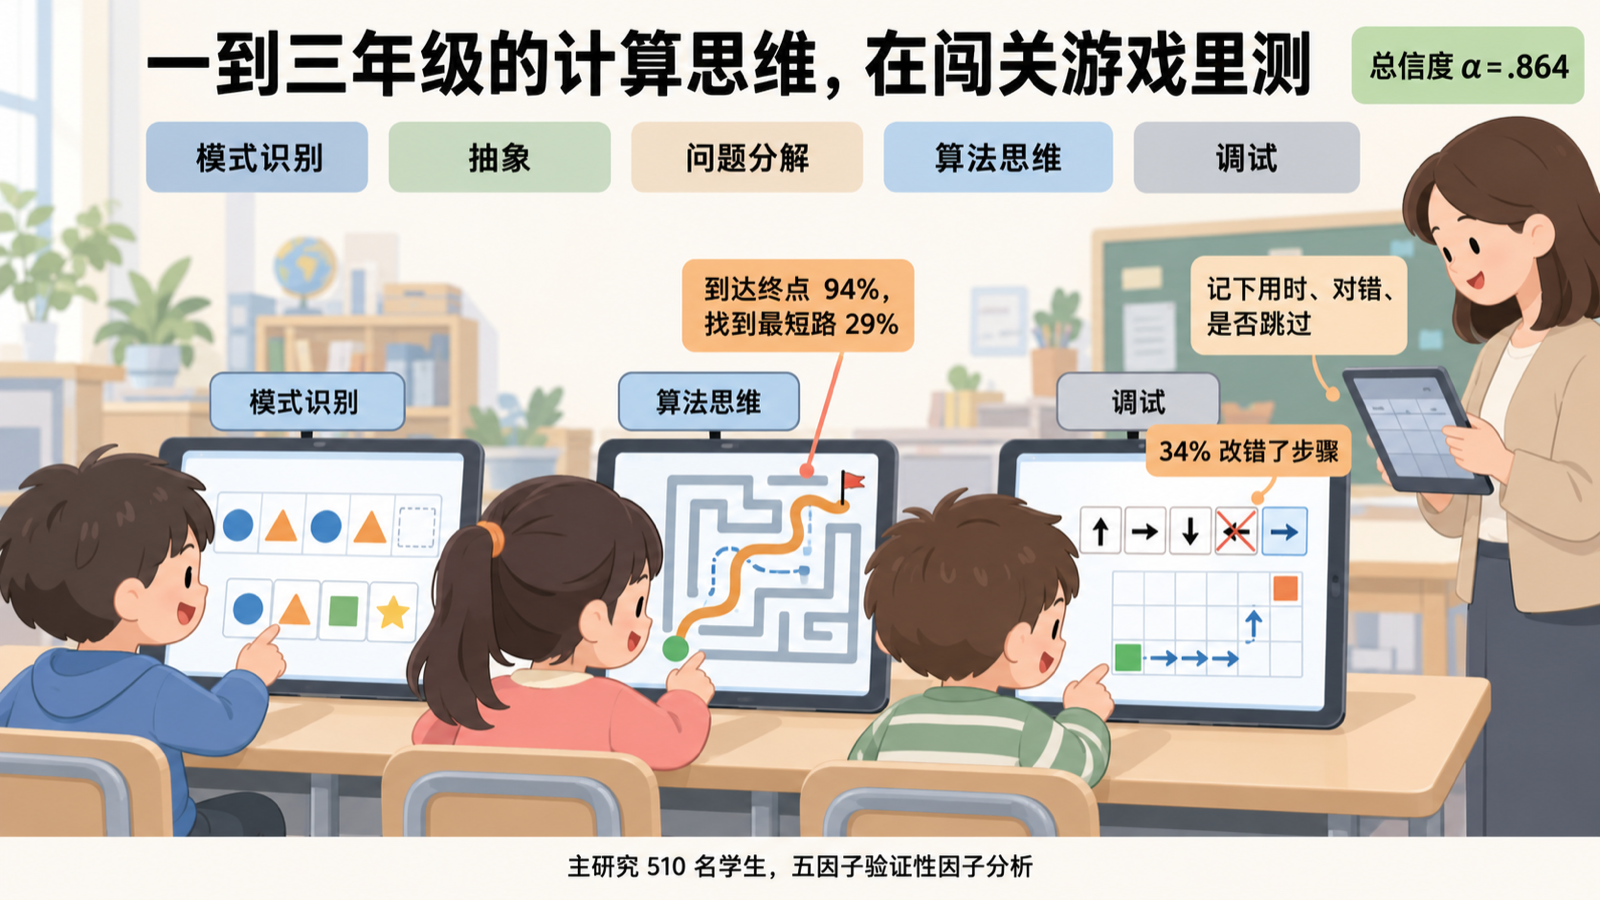
- 设计:证据中心游戏设计把模式识别、抽象、问题分解、算法思维、调试五种实践各落到一个游戏场景,共 49 关;专家评审与儿童认知访谈后试测 74 人,主研究 510 人(一所小学 1–3 年级);每关记录用时、对错、是否跳过。
- 发现:五因子验证性因子分析拟合可接受(RMSEA = .027,CFI = .932),总 α = .864,6 个月重测 r = .558;编程经验相关、游戏经验无关;日志定位三类卡点:多规则协调、可行解与最优解的比较、调试中的整体检查(34% 改错了步骤)。
- 阅读提示:标量不变性 CFI = .896,低于作者自设标准;没有项目反应理论分析与外部效标;计分规则让慢而对的学生得分更低。
人审核、机器编码,整合出 AI 素养五维
A five-dimensional framework for AI literacy in higher education: a human-in-the-loop computational meta-synthesis(Educational Technology Research and Development,10.1007/s11423-026-10752-6)
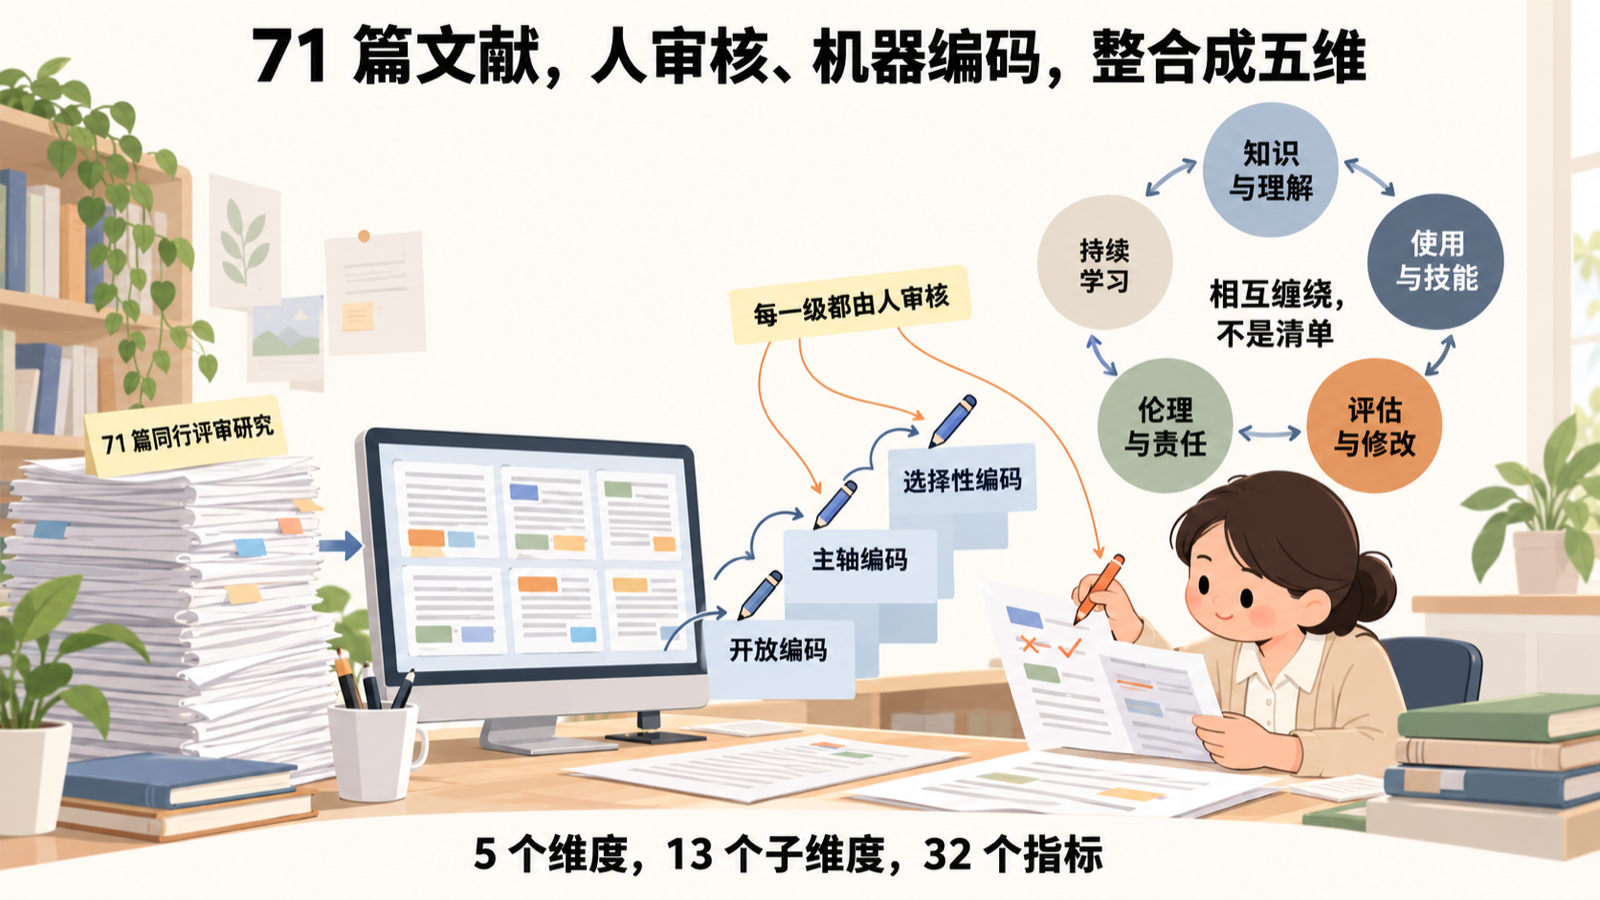
- 设计:LLM 执行扎根理论式开放、主轴、选择性三级编码,研究者逐级治理,语料为 71 篇同行评审研究。
- 发现:五维为知识与理解、使用与技能、评估与修改、伦理与责任、持续学习与发展,下设 13 个子维度、32 个指标;作者主张五维相互缠绕,而不是并列清单。
- 阅读提示:摘要未报告人机编码一致性与模型版本;框架尚未经测量验证。
同样在用 AI,多数学生停在“替我做”
深层交互与学习替代:我国高校学生生成式人工智能应用的现状、风险与对策(《教育发展研究》2026 年第 5 期,何元皓、鲍威,10.14121/j.cnki.1008-3855.2026.05.012)
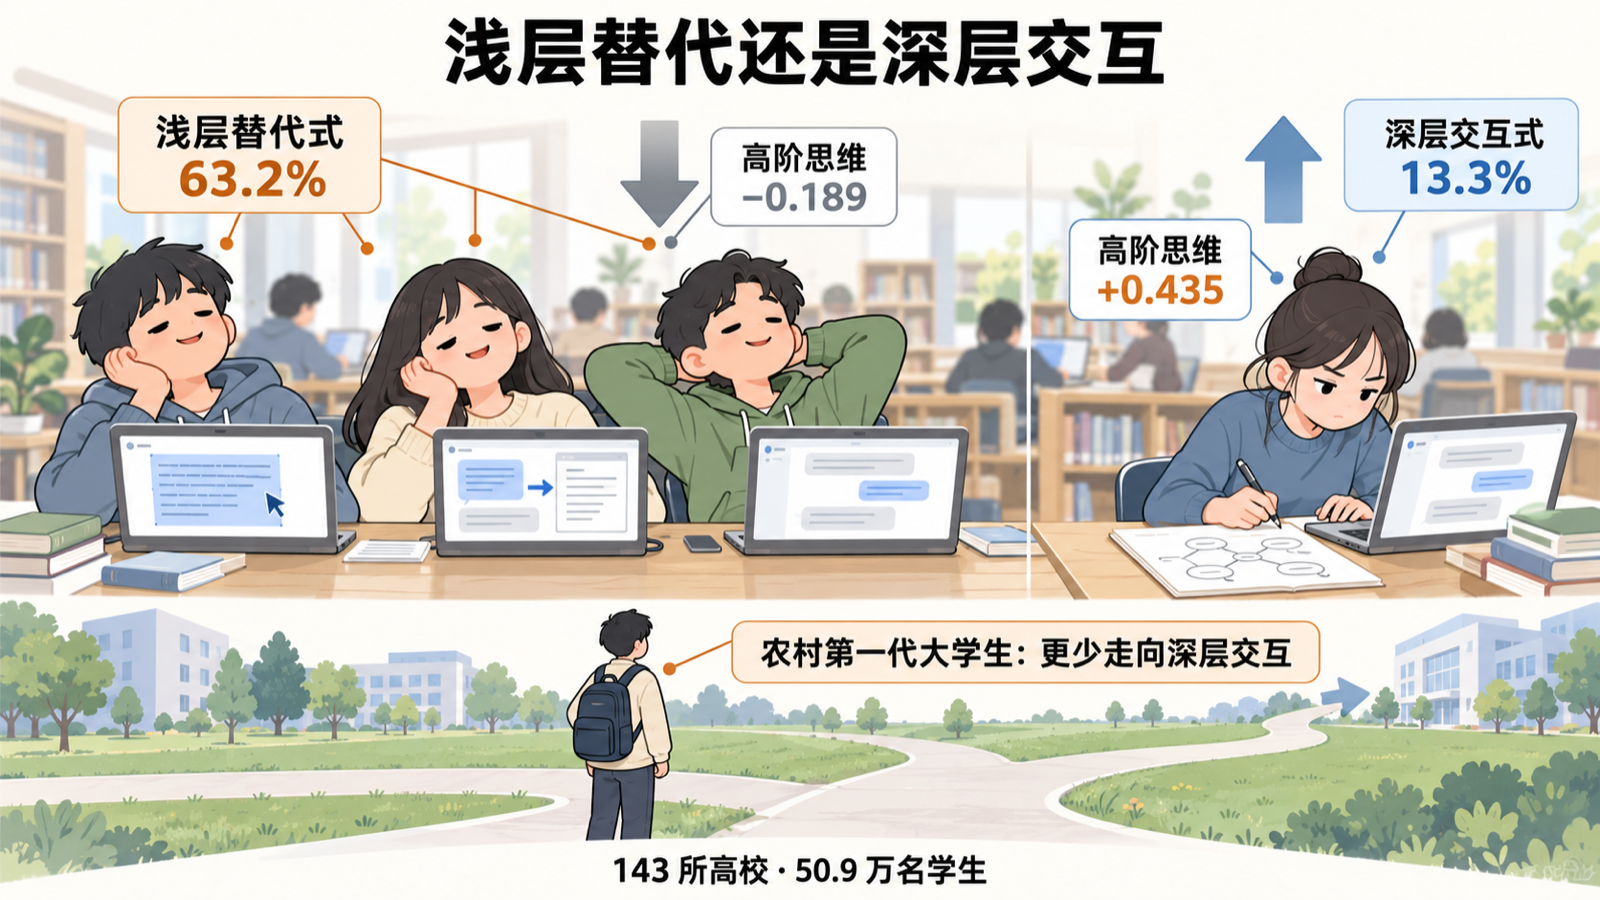
- 设计:2024 年全国高校学生学习状况调查,143 所高校,有效样本 508,946 人;生成式 AI 应用分为未应用、浅层替代式、深层交互式三档(学生自报);高阶思维含批判性思维、创新素养、问题发现解决、自主探究四维;回归之外用工具变量检验内生性,并检验家庭背景的交互作用。
- 发现:应用率 76.4%;63.2% 为浅层替代式,13.3% 为深层交互式。前者与高阶思维综合分负相关(−0.189),后者正相关(+0.435),四个维度方向一致。农村生源、第一代大学生更常使用生成式 AI,却更少进入深层交互;而深层交互对这些学生的正向关联反而更大。
- 阅读提示:横截面自报数据,应用模式的归类规则文中未完整交代;工具变量的排他性约束偏弱;文中把几率比直接表述为“高约 X%”,有一处与表格不一致。
主题地图与趋势
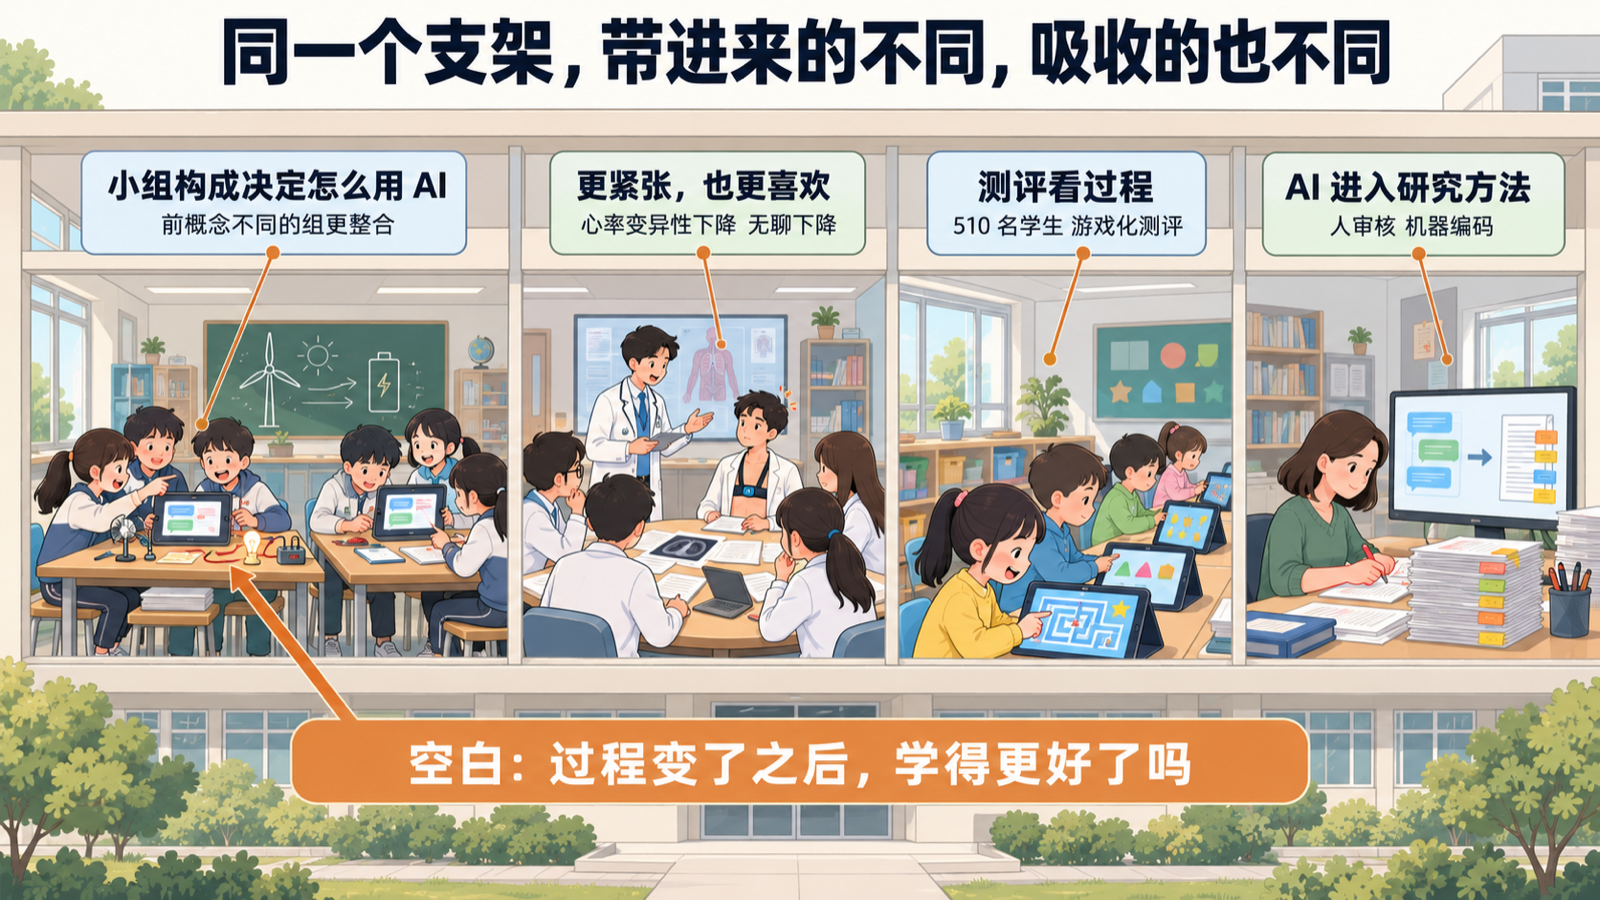
趋势一:AI 支架的效果取决于被谁吸收,而且单位可以是小组。 提示相同、学生提的问题也相似,差别出在小组知识构型决定的交互轨迹上。站在同一层的 AI,被整合还是被当作产出通道,取决于组内是否存在认知分歧。另一项 EFL 研究在个体层给出类似信号:语言焦虑者的注视更死板、输出更冗余(npj Science of Learning,10.1038/s41539-026-00461-3)。
趋势二:激活与舒适并不同向。 生理压力更高的形式,恰恰是学生更喜欢、无聊更少的形式。设计反复进行的 PBL 时,“学生舒服”与“学生被激活”是两个指标。同期还有课堂无聊与创造力的潜在剖面分析(Learning and Instruction,10.1016/j.learninstruc.2026.102496),以及小学动画化计算思维学习中自我调节轨迹的增长混合模型(Computers & Education,10.1016/j.compedu.2026.105773)——人群异质性与情绪状态正在被当作分析对象。
趋势三:测评从总分走向过程证据,量表走向超大样本。 游戏日志把总分掩盖的思维卡点直接呈现出来;一项研究基于 18,295 份问卷建立 K-12 教师 AI 胜任力 22 题量表(ETRD,10.1007/s11423-026-10741-9);高校 AI 素养有了 32 个指标。AI 素养测评同时有了文献框架、教师量表与政策需求。另有一篇专门讨论前测是否纳入分析的方法文(Learning and Instruction,10.1016/j.learninstruc.2026.102495),对准实验设计是直接参考。
趋势四:LLM 进入研究方法本身。 除 LLM 文献编码外,还有一项用 GenAI 做以人为中心的课程映射(Computers and Education: Artificial Intelligence,10.1016/j.caeai.2026.100689)。两项都把“人在回路”放在标题里,接下来要回答的是一致性报告与可复现性。
趋势五:中文期刊里,认知外包从担忧走到干预与大样本证据。 干预端,有研究用思维链、思维树、思维图约束大语言模型输出,对比实验中学生对 AI 结果的盲目采纳减少(《电化教育研究》2026 年第 11 期);也有研究比较四种对话式智能体反馈方式,用问卷、脑电与访谈测量,并报告反馈带来的依赖倾向(同期)。证据端,一项 31 项实验与准实验的元分析发现生成式 AI 促进认知能力,对元认知能力的效应不显著,对高中生为负(《现代远程教育研究》2026 年第 5 期);两项研究用 PISA 2025 中国四省(市)数据分别考察 AI 使用与成绩、学业 AI 使用与自我调节学习的关系(《开放教育研究》2026 年第 5 期)。构念端,“表层投入”被提出来描述高外显参与与低深层证据的错位(同刊),但还没有对应的测量工具。
其他值得一记
- 编程中不同人机交互模式下的情绪动态,面部表情与皮电证据(Computers & Education,10.1016/j.compedu.2026.105771):题目正中人智协同编程与多模态分析,本期未取到摘要,留待下期。
- K-12 数据科学课程的设计型研究(ETRD,10.1007/s11423-026-10735-7):产出五条课程设计要素,面向在职教师。
- 认知负荷理论把“理解”界定为对高元素交互性材料的组块化(Educational Psychology Review,10.1007/s10648-026-10233-5)。
- 121 名成人教育教师(Learning and Instruction,10.1016/j.learninstruc.2026.102501):课堂视频中加信号让教师注意到更多干扰,但正确解释的数量不变。
政策动态
- 《国务院办公厅关于适应人工智能技术发展助力构建就业友好型发展方式的意见》(国办发〔2026〕29 号):主轴是就业,与教育直接相关的是第(八)条“扎实推进人工智能全学段教育”“培养学生探索性、创造性思维能力”,第(九)条“推进人工智能全社会通识教育”,以及第(十三)条把“人机协同”作为社会分工的新特点。对学习科学研究而言,创造性思维的培养与测评、人机协作能力、AI 素养的大规模测评都获得了国务院层面的政策表述。
方法亮点
- 先排除输入差异、再比较过程结构:提问分布、滞后序列、过程挖掘三层递进,适用于任何“同一 AI 不同效果”的研究。
- LLM 三级编码与逐级人工治理:一种可复用、可更新的综述程序;借用时应补报人机一致性与模型版本。
- 证据中心游戏设计与日志的最小可行分析:一个场景只测一个构念;先用难度指数筛出焦点题,再把错误作答编码成路径类别报告频次;同一错误按作答时间分层,区分“快速放弃”与“努力未果”。
- 课堂生理数据的事件锚定窗口与基线校正混合模型:以个人发言起点切窗口、规则先于结果确定;静息参照避开预期唤醒与恢复期;主客观耦合用被试内差值对差值。
新入库计数
英文期刊 17 篇:Computers & Education 3、Computers and Education: AI 1、BJET 1、ETRD 3、Learning and Instruction 3、Educational Researcher 1、Assessment in Education 1、Educational Psychology Review 1、npj Science of Learning 3。中文期刊 25 篇:电化教育研究 4、中国电化教育 4、开放教育研究 4、现代远程教育研究 3、教育研究 1、华东师范大学学报(教育科学版)3、全球教育展望 3(历史补录)、教育发展研究 3(历史补录)。其中 5 篇深读、37 篇卡片。政策 1 条。